Un cluster informatico riunisce diversi server interconnessi che funzionano come una sola risorsa di calcolo. Questa architettura, a lungo relegata ai laboratori di ricerca e ai centri dati specializzati, si è imposta nelle aziende per assorbire carichi di lavoro crescenti. Ma i criteri che definiscono un cluster performante sono cambiati: la potenza bruta non è più sufficiente quando le esigenze riguardano anche la conformità, la tracciabilità e la sovranità dei dati.
Cluster e conformità nel 2026: ciò che l’IA impone alle architetture aziendali
Implementare un cluster di server per addestrare un modello di IA o eseguire inferenze in tempo reale non è più una semplice scelta tecnica. Le aziende che trattano dati sensibili (salute, finanza, settore pubblico) devono ora dimostrare che la loro infrastruttura rispetta norme di sicurezza e governance auditabili.
Secondo un’analisi pubblicata da OneSourceCloud nell’agosto 2026, i cluster vengono valutati sotto l’ottica della conformità operativa, con requisiti di prove di audit e di tracciabilità dettagliata su ogni nodo. La sicurezza dei cluster Kubernetes, ad esempio, è trattata come un argomento di governance continua e non più come una semplice fase di implementazione, secondo VMware.
Per approfondire la definizione del cluster in informatica e comprendere le fasi di implementazione, le risorse tecniche dettagliano i prerequisiti di rete, hardware e software che condizionano il successo di un progetto di clustering.
Questa mutazione trasforma il cluster in un oggetto di conformità tanto quanto di performance. Un cluster mal documentato, senza registri di accesso centralizzati né politiche di crittografia per nodo, diventa un rischio normativo prima di essere un rischio tecnico.
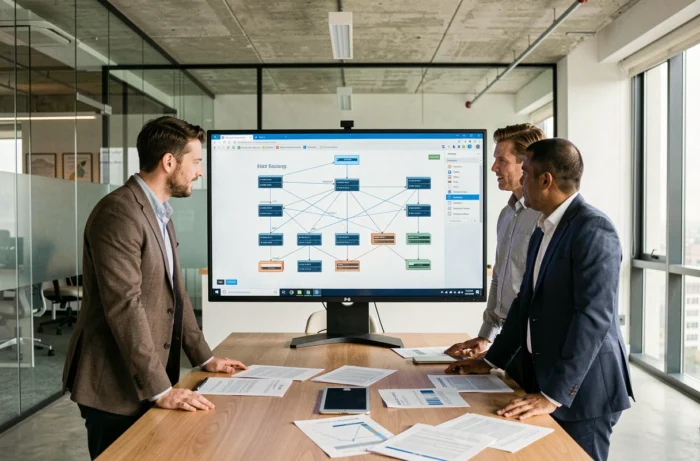
Confronto delle architetture cluster in base al caso d’uso in azienda
Tutti i cluster non rispondono alle stesse esigenze. La scelta tra alta disponibilità, calcolo parallelo o orchestrazione containerizzata dipende dal carico di lavoro target e dal livello di controllo desiderato.
| Tipo di cluster | Caso d’uso principale | Punto distintivo | Vincolo principale |
|---|---|---|---|
| Alta disponibilità (HA) | Applicazioni critiche (ERP, basi transazionali) | Failover automatico tra nodi di riserva | Costo della ridondanza hardware |
| HPC (calcolo ad alte prestazioni) | Simulazione scientifica, modellazione finanziaria | Potenza di elaborazione parallela su migliaia di nodi | Consumo energetico e raffreddamento |
| Kubernetes gestito | Microservizi, inferenza IA, deployment continuo | Orchestrazione automatizzata, scalabilità dinamica | Complessità della governance multi-cluster |
| Cluster data/analitica | Laghi di dati, pipeline ETL, analytics in tempo reale | Manutenzione automatizzata dei nodi | Dipendenza dal fornitore cloud |
I cluster Kubernetes gestiti e i cluster data/analitica condividono una tendenza comune: la manutenzione automatizzata diventa un’aspettativa standard negli ambienti di produzione, come sottolinea Microsoft Learn. Gli aggiornamenti di sicurezza, il bilanciamento dei carichi tra nodi e la sostituzione di nodi difettosi avvengono senza intervento manuale nelle offerte più mature.
Ciò che questa tabella non mostra
Il confine tra queste categorie si sta sfumando. Un cluster Kubernetes può servire sia come infrastruttura HPC per l’addestramento di modelli sia come base di alta disponibilità per API di inferenza. Il cluster non è più “di calcolo” o “di server” ma un mattone di orchestrazione integrato in offerte gestite, secondo le analisi di Blue e Microsoft Learn pubblicate nell’agosto 2026.
Sovranità e latenza: i due criteri che ridisegnano la scelta di un cluster
Il mercato delle infrastrutture di IA aziendale spinge i cluster verso un doppio imperativo che la sola potenza di calcolo non risolve.
Secondo Astute Analytica, l’uso dei cluster si sposta verso i carichi di IA aziendale con un’esigenza crescente di sovranità e latenza. In concreto, ciò significa che le aziende europee che implementano modelli di linguaggio o visione artificiale cercano cluster ospitati sul territorio nazionale, con garanzie contrattuali sulla localizzazione fisica dei nodi e il transito dei dati.
La latenza, a sua volta, condiziona la viabilità delle applicazioni in tempo reale. Un cluster di server distribuito tra due datacenter distanti può offrire una ridondanza geografica, ma a costo di un tempo di risposta incompatibile con l’inferenza continua. Le architetture che privilegiano la prossimità dei nodi in un unico sito guadagnano in latenza, ma perdono in resilienza di fronte a un incidente localizzato.
- La sovranità impone di verificare che ogni nodo del cluster sia ospitato in una giurisdizione compatibile con i regolamenti applicabili (GDPR, regolamenti settoriali).
- La latenza dipende dalla topologia di rete tra i nodi: un cluster co-localizzato nello stesso datacenter offre tempi di comunicazione inter-nodi nettamente inferiori a un cluster distribuito.
- Il compromesso tra resilienza geografica e performance di rete deve essere arbitrato progetto per progetto, in base alla criticità dell’applicazione.
Governance dei cluster Kubernetes: audit, politica di sicurezza e ciclo di vita
Kubernetes si è affermato come il sistema di orchestrazione dominante per i cluster containerizzati. Questa adozione massiccia ha un effetto collaterale: la superficie di attacco di un cluster Kubernetes mal configurato è considerevole.
VMware ha pubblicato nell’agosto 2026 un pacchetto di politiche di sicurezza per il servizio Kubernetes di vSphere, progettato per applicare regole di conformità sin dalla creazione del cluster. L’approccio consiste nell’integrare i controlli di sicurezza nel ciclo di vita del cluster, non solo durante l’audit annuale.
I punti di attenzione riguardano la gestione dei segreti (chiavi API, certificati), l’isolamento di rete tra gli spazi dei nomi e la tracciabilità delle azioni amministrative su ogni nodo. Un cluster che non registra le modifiche di configurazione dei suoi nodi non può soddisfare un audit di conformità, qualunque sia il riferimento (ISO 27001, SOC 2, regolamenti settoriali).
Automazione non significa assenza di controllo
Le offerte di cluster gestiti automatizzano il provisioning e l’aggiornamento dei nodi. Questa automazione riduce gli errori umani, ma sposta la responsabilità verso la configurazione iniziale delle politiche. Un cluster automatizzato senza una politica di sicurezza correttamente definita propaga gli errori più velocemente di un cluster gestito manualmente.
Lo storage dei dati all’interno del cluster segue la stessa logica. I volumi persistenti associati ai nodi devono essere crittografati, replicati in base al livello di criticità e il loro ciclo di vita deve seguire quello delle applicazioni che servono.
L’evoluzione dei cluster in azienda segue una traiettoria chiara: la potenza di calcolo rimane la base, ma la conformità, la sovranità dei dati e l’automazione governata sono le tre dimensioni che determinano la viabilità di un progetto di clustering per i carichi di IA. Un cluster performante che non soddisfa un audit di sicurezza non ha più posto in produzione.